Wstęp
W ostatnim kwartale 2026 roku pojawiają się kolejne aplikacje odtwarzające funkcje programów rozwijanych przez lata. Dotyczy to także flagowych produktów Microsoftu i Adobe: WordCraft służy do pracy z dokumentami, a PhotoCraft odtwarza funkcje Photoshopa. Jak opisuje Decrypt, projekty powstały z pomocą Claude i trafiły do sieci jako open-source.
Firmy już tworzą własne oprogramowanie zamiast płacić za kolejne subskrypcje. W badaniu Retool 35% z 817 respondentów — klientów i osób budujących aplikacje w tym ekosystemie — deklarowało zastąpienie co najmniej jednego narzędzia oferowanego jako usługa, czyli SaaS. Descript ma własny CRM, system do zarządzania relacjami z klientami, zbudowany na Retool i łączący dane z kilku źródeł. Moim zdaniem koszt samego pisania oprogramowania będzie dążył do zera. Dojrzałość, bezpieczeństwo i utrzymanie nadal wymagają pracy, ale kierunek tej zmiany uważam za przesądzony.
Co jest więc wartością firmy? Przetestowany model biznesowy i płacący klienci, a obok nich — moim zdaniem jeszcze ważniejsze — dane i wiedza zgromadzone przez lata. Zainteresowanie ich pozyskiwaniem widać w zapowiedzi micro1: firma ogłosiła przeznaczenie miliarda dolarów w ciągu kolejnych 12 miesięcy na dane przedsiębiorstw. To deklaracja przyszłych wydatków. Niszową, uporządkowaną wiedzę, do której inni nie mają dostępu, uważam za najcenniejszą część dorobku firmy. Trzeba jej strzec i umieć na niej zarabiać.
Na rynku dzieje się zbyt wiele, żeby samodzielnie sprawdzić każde rozwiązanie. Dlatego postanowiliśmy przeanalizować rynek i zebrać procesy i narzędzia pozwalające na przejście od firmy „human driven”, w której wiedzę trzeba wydobywać od ludzi, przez „data driven”, korzystającą z uporządkowanych danych, do „agent driven”, w której z przygotowanej wiedzy mogą korzystać także agenci AI. Ta droga zaczyna się od rozpoznania danych i obejmuje ich porządkowanie, udostępnianie oraz późniejsze utrzymanie.
Od czego zaczynamy
Punktem wyjścia jest firma, której informacje są rozproszone między ludźmi, dokumentami i systemami. Zestaw źródeł będzie różny, ale w przeglądzie warto uwzględnić sześć grup:
- Narzędzia zarządzania i komunikacji wewnętrznej: Microsoft 365, Teams, SharePoint, Slack czy Google Docs — wraz z wątkami rozmów, zadaniami i załącznikami.
- Komunikację zewnętrzną: stronę WWW, LinkedIn i inne kanały społecznościowe firmy.
- Dokumenty na dyskach sieciowych i lokalnych, w folderach zespołów oraz pracowników.
- Systemy CRM i ERP, czyli systemy zarządzania relacjami z klientami oraz zasobami przedsiębiorstwa.
- Systemy specjalistyczne, np. obsługujące linię produkcyjną lub sprzedaż w punktach handlowych (POS).
- Dane analityczne i historyczne: centralne repozytoria, hurtownie danych oraz data lake — zbiorcze magazyny danych w różnych formatach.
Do czego dążymy
Celem firmy jest przygotowanie całej jej wiedzy do wykorzystania przez agentów AI — programy, które korzystają z modelu i wywołują narzędzia, aby pracować na danych. Dostęp ma prowadzić przez serwer MCP, czyli Model Context Protocol, protokół łączący aplikacje AI z narzędziami i źródłami informacji. Wiedza powinna być aktualna, możliwa do sprawdzenia i dostępna zgodnie z uprawnieniami. Odpowiedź na pytanie o szczegółowy fakt oraz analiza wielu rekordów muszą przy tym mieścić się w czasie użytecznym dla pracownika.
Na jakie pytania odpowiadamy
- Co trzeba zrobić z danymi i w jakiej kolejności?
- Jakie narzędzia wykorzystać?
- Jaki nakład pracy będzie potrzebny, aby przejść od punktu wyjścia do celu?
- Jak zmienić codzienną pracę i odpowiedzialność za informacje, aby dane dostępne agentom stale odzwierciedlały rzeczywistość firmy?
Spis treści
1. Inwentaryzacja i kolejność przygotowania danych
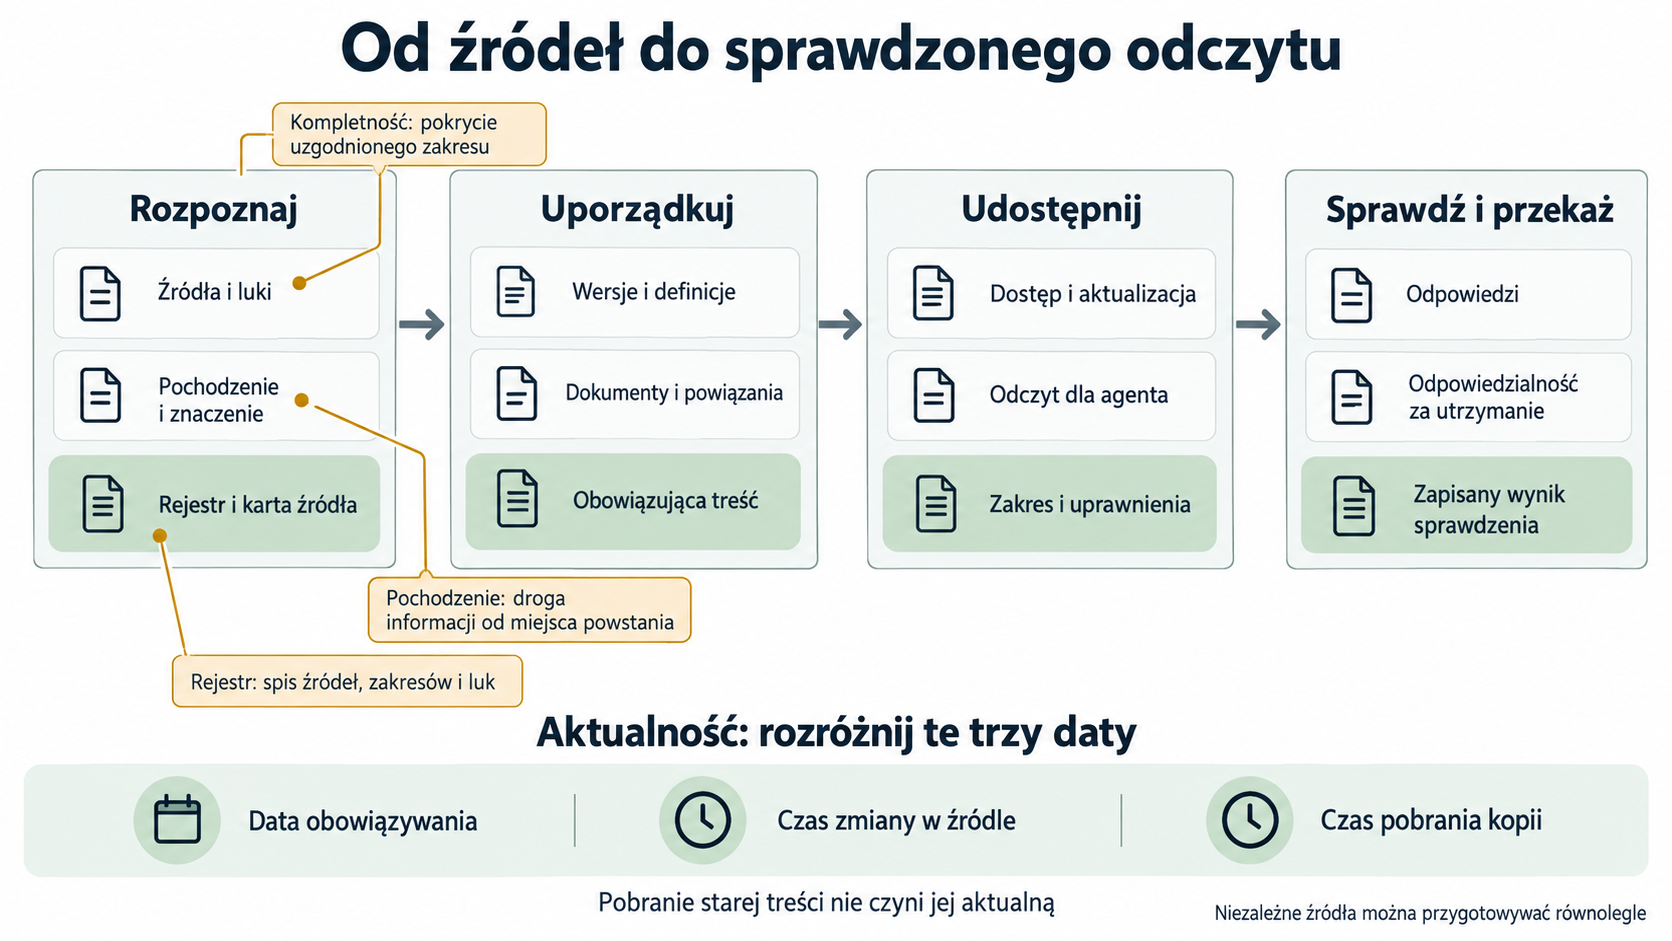
Zacząłbym od rozpoznania źródeł w całej firmie. Potrzebujemy wspólnego obrazu tego, jakie informacje istnieją, skąd pochodzą i czego jeszcze nie udało się odnaleźć. Na tej podstawie można ustalić kolejność porządkowania i sprawdzania danych.
1.1. Rejestr źródeł danych całej firmy
Koordynator prac zakłada wspólny rejestr źródeł i zaprasza do jego uzupełnienia przedstawicieli wszystkich obszarów firmy oraz administratorów. Dla każdego obszaru sprawdzają sześć grup ze wstępu. Jednostką wpisu może być biblioteka dokumentów, kanał komunikacji, obiekt w CRM, zbiór danych lub archiwum. Samo wpisanie nazwy „SharePoint” nie powie, które biblioteki obejmuje rozpoznanie. Wzór rejestru znajduje się w sekcji 2.1.
Przy każdym wpisie zapisujemy stan: rozpoznany, sprawdzony albo wymagający wyjaśnienia. Brak dostępu do archiwum i brak samego archiwum to dwie różne informacje. Koordynator odnotowuje obie sytuacje, przypisuje osobę do wyjaśnienia i zachowuje datę ostatniego sprawdzenia. Dzięki temu lista pokazuje również granice naszej wiedzy o firmie.
Przykład: dział sprzedaży wskazuje CRM i bibliotekę umów. Pracownik dodaje, że część aneksów pozostaje w skrzynkach osób prowadzących klientów. Rejestr obejmuje więc trzy miejsca, a przy aneksach pojawia się zadanie: ustalić brakujące dokumenty, przenieść zatwierdzone wersje do uzgodnionego źródła i sprawdzić powiązanie z klientami. Sam przegląd CRM nie ujawniłby kompletności umów.
1.2. Pochodzenie, kompletność i aktualność informacji
Dla ważnej informacji trzeba umieć prześledzić drogę od miejsca powstania do wyniku udostępnianego agentowi. Właściciel źródła wraz z analitykiem zapisuje, gdzie informacja jest tworzona, gdzie powstają jej kopie i kto rozstrzyga różnice. Ten opis pochodzenia łączymy z identyfikatorem źródła w rejestrze. Istniejący diagram firmy może pomóc odnaleźć przekazania danych; sposób jego odczytu opisuję w sekcji 2.3.
Kompletność sprawdzamy względem określonego zakresu: których klientów, dokumentów, okresów i pól potrzebujemy. Aktualność wymaga natomiast rozróżnienia daty obowiązywania informacji, czasu jej zmiany w źródle i czasu pobrania kopii. Udane pobranie starego dokumentu nadal daje stary dokument. Właściciel ustala wymaganą świeżość, a administrator sprawdza, czy cała droga udostępnienia ją zachowuje.
Przykład: umowa określa termin płatności, późniejszy aneks go zmienia, a w CRM pozostała wcześniejsza wartość. Osoba odpowiedzialna za umowy potwierdza datę wejścia aneksu w życie i wskazuje źródło obowiązujące. Opiekun CRM poprawia rekord. W rejestrze zostaje odnośnik do aneksu i rozstrzygnięcia, dzięki czemu kolejna odpowiedź może zostać porównana z właściwą wersją.
1.3. Plan porządkowania danych i kryteria odbioru
Z rejestru powstaje lista prac we wspólnym arkuszu lub narzędziu zadań. Każdy wiersz ma ID źródła, osobę odpowiedzialną i dowód wykonania. Proponuję następujący porządek; zadania dla niezależnych źródeł mogą przebiegać równolegle.
| Zadanie | Potrzebne wejście | Wykonawca | Zapisany rezultat i kryterium odbioru |
|---|---|---|---|
| Rozpoznanie źródeł i luk | Lista obszarów firmy oraz sześć grup ze wstępu | Koordynator, pracownicy i administratorzy | Rejestr obejmuje każdy obszar; nieznany zakres ma właściciela wyjaśnienia. |
| Ustalenie pochodzenia i znaczenia | Wpisy rejestru, próbki danych, diagramy | Właściciel źródła z analitykiem | Karta źródła pozwala prześledzić próbkę do miejsca powstania. |
| Rozstrzygnięcie wersji i definicji | Sprzeczności, kopie, niejasne pola | Właściciel merytoryczny | Słownik i decyzje wskazują obowiązującą wersję oraz znaczenie danych. |
| Porządkowanie źródeł | Uzgodnione reguły i lista braków | Opiekun dokumentów lub inżynier danych | Poprawione dokumenty, klucze i powiązania przechodzą kontrolę próbki. |
| Przygotowanie dostępu i aktualizacji | Gotowe źródła oraz zatwierdzone grupy odbiorców | Administrator integracji | Zapis konfiguracji i test pokazują pobranie zmian, usunięć oraz właściwe uprawnienia. |
| Udostępnienie odczytu agentowi | Przygotowane źródło, indeks lub baza | Administrator warstwy MCP | Opis narzędzia określa zakres; wynik zachowuje identyfikator i czas stanu źródła. |
| Sprawdzenie odpowiedzi | Pytania i odpowiedzi referencyjne | Właściciel danych z osobą testującą | Rejestr wyników obejmuje szczegół, analizę zbioru i odmowę dostępu. |
| Przekazanie utrzymania | Wyniki odbioru i pozostałe braki | Właściciel źródła oraz opiekun integracji | Zapisane są odpowiedzialność, zastępstwo i sposób ponownego sprawdzenia po zmianie. |
Ta kolejność chroni przed porządkowaniem według nieuzgodnionych zasad. Najpierw trzeba ustalić, co w firmie oznacza „aktywny klient”, żeby później poprawnie przygotować filtr. Najpierw trzeba wskazać obowiązującą wersję dokumentu, żeby jej fragmenty trafiły do wyszukiwania. Odbiór źródła zamyka zadanie dopiero po zapisaniu wyniku sprawdzenia.
2. Narzędzia do zbierania i porządkowania wiedzy
Punktem odniesienia są źródła już używane w firmie. Rejestr można zacząć od wspólnego arkusza, a narzędzia do skanowania, odczytu dokumentów i synchronizacji dobierać do rozpoznanych braków. Przy każdym wyborze warto wskazać wejście, zapisany wynik i osobę, która potwierdzi jego poprawność.
2.1. Wspólny rejestr źródeł i szablony dla pracowników
W firmie korzystającej z Microsoft 365 rejestr może przyjąć postać Microsoft Lists. Narzędzie pozwala tworzyć listy m.in. z Excela, CSV lub szablonu i udostępnia formularz dodawania wpisów. Koordynator przygotowuje kolumny, a administrator ustawia dostęp, wersjonowanie i sposób zatwierdzania. Współdzielony Excel może pomieścić ten sam zestaw pól; zasady edycji i zatwierdzania trzeba wówczas ustalić dla wybranego miejsca zapisu.
| Pole rejestru | Co wpisujemy | Kto uzupełnia lub zatwierdza |
|---|---|---|
| ID, obszar, system i adres | Jednoznaczny identyfikator oraz miejsce przechowywania | Koordynator i administrator |
| Typ i zakres danych | Rodzaj dokumentów lub rekordów, foldery, okres i granice zbioru | Pracownik korzystający ze źródła |
| Pochodzenie | Gdzie informacja powstaje, skąd jest kopiowana i dokąd trafia | Pracownik tworzący dane, z pomocą analityka |
| Właściciel i opiekun | Kto rozstrzyga znaczenie, a kto wykonuje poprawki | Osoba odpowiedzialna za obszar |
| Definicje i wersja | Znaczenie pól, obowiązująca wersja, dostępna historia | Właściciel merytoryczny |
| Pokrycie i luki | Co sprawdzono, czego brak i czego jeszcze nie wiadomo | Koordynator po porównaniu zgłoszeń i odczytów |
| Aktualizacja | Zdarzenie powodujące zmianę, data obowiązywania i sposób odświeżania | Właściciel oraz administrator integracji |
| Dostęp | Odbiorcy, ograniczenia i konto używane do pobrania | Administrator; właściciel zatwierdza zakres |
| Sprawdzenie i następna czynność | Data, próbka, odnośnik do wyniku, błąd i osoba odpowiedzialna | Osoba testująca oraz koordynator |
Pracownik dostaje formularz z tymi polami i wypełnia część dotyczącą swojej wiedzy: co zapisuje, gdzie, skąd czerpie informację, jakie zna wyjątki i kto może je rozstrzygnąć. Może zaznaczyć „nie wiem”. Administrator uzupełnia identyfikatory i dostęp, właściciel potwierdza znaczenie, a koordynator łączy wpisy dotyczące tego samego źródła. Wynik pozostaje we wspólnym rejestrze; dodatkowe objaśnienia trafiają do powiązanej karty źródła.
Przykład: karta „D-014 / sprzedaż / biblioteka umów” zawiera adres biblioteki, zakres „podpisane umowy i aneksy”, właściciela po stronie sprzedaży i grupę uprawnionych odbiorców. Pole „luki” wskazuje brak aneksu klienta K-124, a „następna czynność” — osobę, która ma potwierdzić jego wersję i uzupełnić bibliotekę. Puste pole historii ma osobny status „do ustalenia”.
2.2. Konektory i agent wspierający inwentaryzację
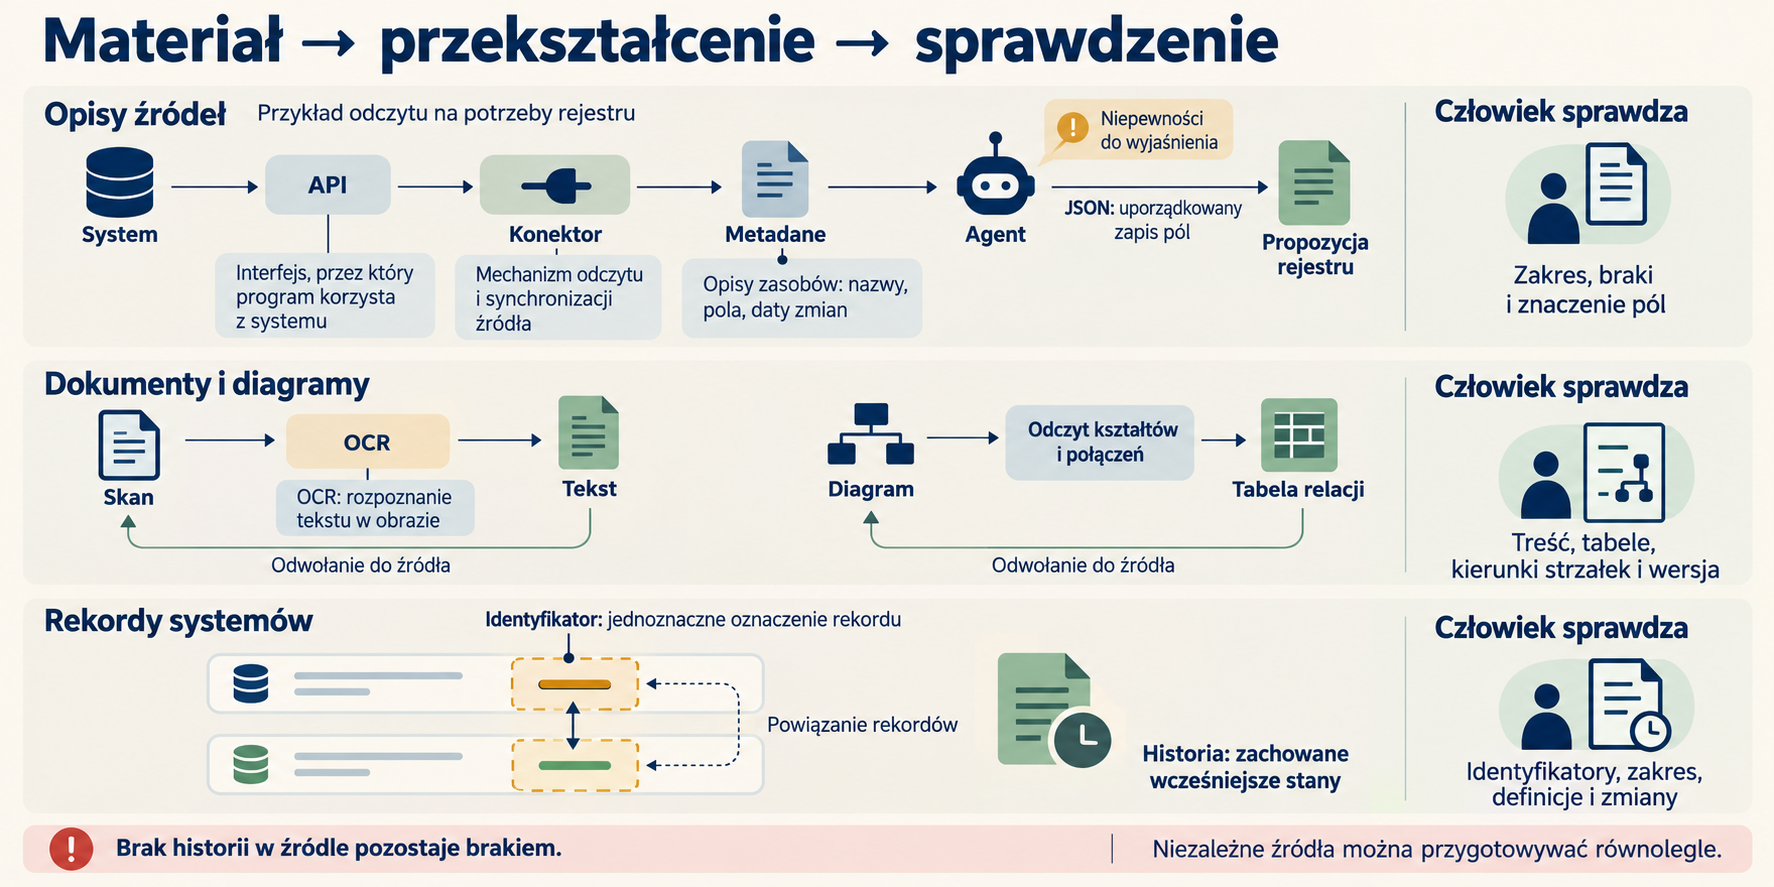
API to interfejs, przez który program może korzystać z systemu. Konektor realizuje przez taki interfejs lub inną dostępną drogę odczyt i synchronizację źródła. Administrator określa dozwolony zakres, po czym zbiera metadane — opisy zasobów, takie jak nazwy folderów, pola tabel, identyfikatory i czasy zmian. Agent może uporządkować ten materiał według schematu rejestru oraz wskazać pytania wymagające wiedzy człowieka.
W środowisku z Microsoft Purview skanowanie pobiera metadane do mapy danych i katalogu. Administrator wybiera źródło oraz zakres skanu, a następnie porównuje odnalezione zasoby z listą oczekiwanych. Wynik trafia do katalogu, skąd ustalenia można powiązać z rejestrem firmy. Zakres odczytu i poziom metadanych zależą od źródła oraz konektora. Właściciel nadal musi potwierdzić znaczenie pól i wyjaśnić brakujące miejsca.
Do uporządkowania wyeksportowanych opisów można wykorzystać duży model językowy, czyli LLM, za pośrednictwem agenta takiego jak Codex. Tryb nieinteraktywny Codexa przyjmuje wymagany schemat JSON — uporządkowanego zapisu pól — i pozwala zapisać wynik do pliku. Osoba techniczna może więc przekazać uzgodniony wyciąg metadanych i otrzymać plik do importu oraz listę braków. Kontrola schematu sprawdza format, a właściciel danych sprawdza przypisane znaczenie.
- Administrator zapisuje zakres odczytu: system, foldery lub obiekty, okres, użyte konto oraz pominięte miejsca.
- Agent proponuje wpisy rejestru, łączy podobne nazwy jako kandydatów do sprawdzenia i oznacza niepewności.
- Pracownicy uzupełniają luki, a właściciele rozstrzygają, czy podobnie nazwane zasoby oznaczają to samo.
- Koordynator importuje zatwierdzone wpisy i porównuje pokrycie z listą obszarów firmy. Braki pozostają na liście prac.
Przykład: agent znajduje pola „status” w CRM i ERP. Zapisuje oba z ich źródłami, bez scalania definicji. Pracownik wyjaśnia, że pierwsze oznacza etap kontaktu z klientem, a drugie stan zamówienia. W rejestrze powstają dwa pojęcia i wskazanie relacji między rekordami.
2.3. Odczytywanie istniejących diagramów firmy
Jeśli firma ma bibliotekę diagramów, warto ją wykorzystać przy szukaniu źródeł i przekazań informacji. Sam przekazuję takie materiały Codexowi, żeby pomógł je odczytać. Przy pracy zespołowej zachowałbym także wersję diagramu i zapis interpretacji: które ustalenie pochodzi z której strony, etykiety lub połączenia. Osoba znająca dany obszar porównuje wynik z rysunkiem i rzeczywistą pracą.
| Źródło diagramu | Sposób pozyskania materiału | Wynik do wykorzystania w rejestrze | Co sprawdza człowiek |
|---|---|---|---|
| Miro | Administrator korzysta z API elementów tablicy oraz opisu połączeń między elementami. | Wyciąg etykiet, obiektów i relacji z odwołaniem do tablicy, zapisany przy karcie źródła. | Czy odczyt objął właściwe elementy; wklejony obraz może wymagać osobnej interpretacji. |
| Diagrams.net / Draw.io | Autor diagramu wykonuje eksport do XML, uwzględniając potrzebne strony. | Plik z opisem kształtów i połączeń, z którego powstaje tabela systemów i przekazań. | Zakres stron, kierunki strzałek i znaczenie skrótów; same wyciągnięte etykiety nie wystarczą. |
| Visio | Osoba techniczna przygotowuje wyciąg z pliku VSDX, pakietu zawierającego części XML. | Opis stron, kształtów, tekstów i relacji wraz ze wskazaniem miejsca w pliku. | Kompletność wyciągu na danym diagramie; opis VSDX nie obejmuje starego binarnego formatu VSD. |
Alternatywą jest obraz diagramu: Codex CLI obsługuje wejście obrazowe. Prośba o odczyt powinna obejmować systemy, dane wejściowe i wyjściowe, miejsca zapisu, wskazanych odpowiedzialnych oraz niepewności. Wynik zapisujemy jako tabelę powiązaną z oryginałem. Pracownik sprawdza tekst i strzałki, administrator potwierdza połączenia, a dopiero zatwierdzone ustalenia uzupełniają rejestr.
Przykład: diagram zawiera ciąg „formularz WWW → CRM → ERP” i boczną strzałkę „cennik.xlsx → oferta”. Odczyt ujawnia dodatkowe źródło cen. W tabeli interpretacji przy cenniku zostają pytania: gdzie leży plik, kto go zatwierdza i po czym rozpoznać obowiązującą wersję? Pracownik sprzedaży uzupełnia odpowiedzi, administrator sprawdza rzeczywiste przekazanie danych, a koordynator nadaje źródłu ID. Diagram pomógł odnaleźć brak w katalogu.
2.4. Narzędzia do porządkowania dokumentów i danych systemowych
Dokument wymaga zachowania treści, wersji i miejsca, z którego pochodzi cytat. Rekord systemowy potrzebuje jednoznacznych identyfikatorów i relacji. Odpowiedź o przeszłości wymaga jeszcze danych historycznych. Te różnice pomagają dobrać narzędzie i sprawdzian jego wyniku.
| Zadanie i narzędzie | Wejście → zapisany wynik | Przygotowanie i kontrola |
|---|---|---|
| Odczyt dokumentów: Docling | PDF, dokumenty biurowe lub skany → struktura dokumentu i fragmenty do dalszego wyszukiwania. | Opiekun wskazuje obowiązującą wersję. Osoba techniczna zachowuje adres i pozycję fragmentu, a pracownik porównuje tabele, liczby i daty po OCR, czyli rozpoznaniu tekstu w obrazie. |
| Pobieranie rekordów Salesforce: Airbyte | Dostępne obiekty źródła → rekordy w skonfigurowanym miejscu docelowym. | Administrator wybiera obiekty i tryb synchronizacji. Analityk porównuje identyfikatory, zakres oraz próbkę rekordów z systemem źródłowym. |
| Rejestrowanie zmian PostgreSQL: Debezium | Początkowy stan bazy i jej rejestr zmian → strumień zdarzeń do dalszego przetwarzania. | Inżynier danych sprawdza ciągłość odczytu, zmiany i usunięcia oraz ich powiązanie z identyfikatorami biznesowymi. |
| Ujednolicenie obliczeń: dbt Semantic Layer | Modele danych i uzgodnione definicje miar → wspólne reguły używane w zapytaniach. | Analityk uzgadnia znaczenie miary z właścicielem danych i porównuje wynik z zapytaniem referencyjnym. |
Przy dokumencie zachowałbym ID źródła, adres oryginału, wersję, datę obowiązywania, czas pobrania, właściciela i reguły dostępu. Przy rekordach — również znaczenie pojedynczego wiersza, jednostki, strefę czasu i reguły łączenia. Jeśli system przechowuje wyłącznie ostatni status, trzeba jawnie oznaczyć brak wcześniejszej historii. Konektor nie odtworzy zdarzeń, których źródło nie zachowało.
W systemach specjalistycznych trzeba sprawdzić te same elementy na ich własnych danych. Square Orders API udostępnia dane zamówień z systemu sprzedaży; pobrane rekordy mogą zasilić przygotowany zbiór analityczny. Dokumentacja zwraca uwagę na czas utworzenia zamówienia z punktu działającego offline: może to być czas otrzymania go przez serwer. Administrator i właściciel danych powinni potwierdzić znaczenie dat, zanim analityk połączy je z innym źródłem.
Przykład opisany przez dostawcę: TIME korzysta z Glean do dostępu do archiwum. Opis pokazuje indeksowanie materiałów, wyszukiwanie, podsumowania i linki do treści. Warto przyjrzeć się temu jako przykładowi udostępnienia historycznych dokumentów z możliwością powrotu do źródła; zakres własnego archiwum i jego wersje trzeba ustalić osobno.
3. Udostępnianie danych agentom z zachowaniem uprawnień
Po uporządkowaniu źródeł trzeba połączyć je z agentem tak, aby odpowiedź zachowywała pochodzenie i zakres dostępu. Sposób odczytu zależy od rodzaju pytania, a sprawdzenie obejmuje całą drogę od źródła do odpowiedzi.
3.1. Warstwa dostępu MCP i uprawnienia do źródeł
W architekturze MCP aplikacja AI łączy się z serwerami udostępniającymi narzędzia i zasoby. Firmowy serwer może wystawiać nazwane odczyty przygotowanych danych. Dokumenty nadal mogą pozostawać w swojej bibliotece, rekordy w CRM, a zestawienia w bazie analitycznej. Jedna aplikacja może korzystać z wielu serwerów, więc pełny katalog wiedzy firmy nie wymaga przeniesienia wszystkich danych do jednego magazynu.
- Właściciel źródła wskazuje udostępniane informacje, ich znaczenie i grupy odbiorców.
- Administrator konektora zapisuje zakres pobrania, sposób odświeżania i obsługę usunięć.
- Osoba przygotowująca indeks lub bazę zachowuje metadane źródła i reguły filtrowania dostępu.
- Administrator MCP opisuje narzędzia, parametry, ograniczenia odczytu oraz tożsamość, z której praw korzystają.
- Osoba testująca sprawdza, czy wynik dla danego użytkownika zawiera wyłącznie dostępne mu dane i wskazuje właściwe źródło.
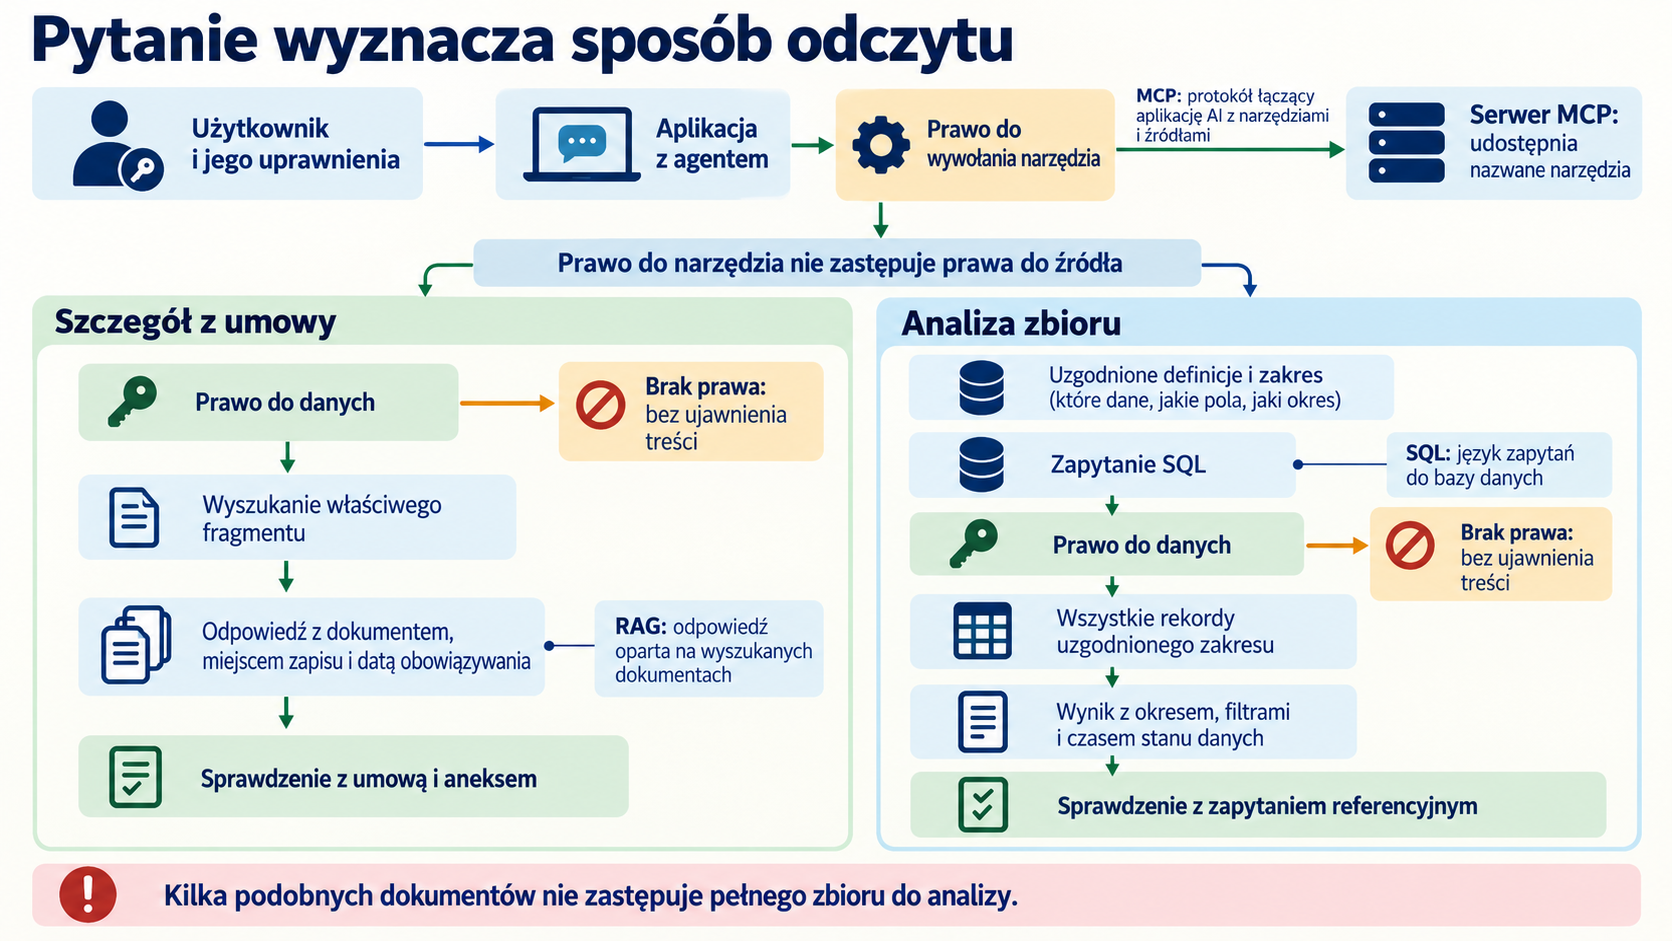
Zakres katalogu i zakres uprawnień rozpatrujemy osobno. W Onyx konektor pobiera źródła do wyszukiwania, a ustawienie Public udostępnia je użytkownikom Onyx także wtedy, gdy dokument w źródle jest prywatny. Synchronizacja uprawnień jest funkcją Enterprise i zależy od konektora oraz sposobu logowania. Przed udostępnieniem administrator sprawdza więc na dwóch kontach, co rzeczywiście wraca w wynikach. Podobnie prawo do wywołania narzędzia MCP nie zastępuje prawa do odczytu dokumentu lub tabeli.
Przykład opisany przez dostawcę: Electra połączyła w Dust Intercom, Slack i Notion oraz własny MCP do danych zaplecza, m.in. sesji ładowania, kont i płatności. Pracownik sprawdza odpowiedź przed jej wysłaniem. Ten opis pozwala zobaczyć, jak wiedza z dokumentów i komunikacji łączy się z odczytem danych systemowych.
3.2. Dane do pytań o fakty i do analiz
Pytanie o warunek zapisany w umowie i pytanie o cały kwartał zamówień wymagają innego przygotowania danych. W pierwszym przypadku szukamy obowiązującego zapisu. W drugim potrzebujemy kompletnego zbioru oraz uzgodnionych zasad liczenia. Poniższe przykłady są dydaktyczne.
| Element | Przykład: szczegółowy fakt | Przykład: analiza zbioru |
|---|---|---|
| Pytanie | Jaki termin płatności obowiązuje klienta K-124? | Jaki odsetek zamówień dostarczono po obiecanym terminie w ostatnim zamkniętym kwartale, według regionu? |
| Potrzebne dane | Umowa, aneksy, ID klienta i daty obowiązywania. | Zamówienia, obiecane i rzeczywiste daty, statusy, regiony oraz potrzebna historia zmian. |
| Przygotowanie znaczenia | Rozstrzygnięcie wersji i wyjątków w warunkach. | Wybór daty określającej kwartał; reguły anulowań, częściowych dostaw, brakujących dat i zliczania. |
| Odczyt | Wyszukanie właściwego dokumentu oraz fragmentu potwierdzającego warunek. | Zapytanie obejmujące wszystkie rekordy z uzgodnionej populacji. |
| Odpowiedź | Termin z identyfikatorem dokumentu, pozycją zapisu i datą obowiązywania. | Wynik według regionów, licznik i mianownik, okres, filtry oraz czas stanu danych. |
| Sprawdzenie | Uprawniona osoba porównuje odpowiedź z umową i aneksem. | Analityk porównuje wynik z zapytaniem referencyjnym i sprawdza próbkę rekordów oraz wyłączeń. |
Dla przygotowanych zbiorów analitycznych przykładem jest BigQuery z narzędziami MCP. Udostępnia odczyt metadanych oraz wykonywanie zapytań SQL, czyli zapytań do bazy danych. Administrator wybiera role i narzędzia odpowiednie do odczytu, a analityk zapisuje wynik wraz z zapytaniem oraz sprawdza go na tej samej populacji. Artykuł Google Cloud pokazuje narzędzia listowania zbiorów i tabel oraz wykonywania zapytań; temat udostępniania zbiorów klientom MCP rozwija nagranie Abirami Sukumaran.
Wyszukanie kilku podobnych dokumentów nie daje podstawy do policzenia odsetka dla całej firmy. Równie ważna jest historia: jeśli zachowano wyłącznie ostatni obiecany termin dostawy, wcześniejsza obietnica może być już niedostępna. Analityk odnotowuje taki brak przy pytaniu i źródle, zamiast wyliczać wynik na niezgodnym zakresie.
Przykład: na pytanie „Jakie tematy pojawiają się w reklamacjach?” agent może przygotować syntezę dokumentów. Właściciel zbioru ustala kanały i okres, analityk łączy wiadomości należące do tej samej sprawy, a wynik wskazuje materiały potwierdzające poszczególne tematy. Jeśli chcemy podać ich częstość, trzeba jeszcze ustalić, czy liczymy wiadomości, sprawy czy klientów.
3.3. Sprawdzanie odpowiedzi, aktualności i dostępu
Właściciel danych przygotowuje pytania i odpowiedzi referencyjne, a osoba testująca zapisuje wyniki we wspólnym rejestrze sprawdzeń. Każdy wpis zawiera pytanie, użyte konto lub rolę, źródło i wersję, oczekiwany oraz uzyskany wynik, datę, czas odpowiedzi i odnośnik do dowodu. Rozbieżność otrzymuje właściciela poprawki i wynik ponownego sprawdzenia.
| Co sprawdzamy | Jakiego dowodu szukamy |
|---|---|
| Znany szczegół i analiza zbioru | Zgodność z dokumentem lub zapytaniem referencyjnym przy tych samych definicjach i zakresie. |
| Brak informacji albo sprzeczność | Wskazanie braku lub rozbieżności, bez dopisania nieudokumentowanej wartości. |
| Użytkownik bez dostępu | Brak ujawnienia niedostępnej treści, fragmentu lub nazwy dokumentu. |
| Zmiana treści | Zapis czasu zmiany w źródle i momentu, od którego odpowiedź korzysta z nowej wersji. |
| Usunięcie lub wycofanie | Potwierdzenie, że stara treść zniknęła z bieżącego odczytu albo jest właściwie oznaczona jako historyczna. |
| Odebranie uprawnień | Powtórzone pytanie pokazuje, że dawna treść przestała być dostępna dla tej osoby. |
| Zmiana pola lub definicji | Wykryta różnica, poprawione mapowanie i zgodny wynik po ponownym sprawdzeniu. |
| Szybkość odpowiedzi | Pomiar dla reprezentatywnych pytań, wielkości wyniku i opisanego obciążenia. |
Techniczny przykład takiego rozwiązania zawiera azure-search-openai-demo: aplikacja odpowiada na podstawie wyszukanych dokumentów, co określa się jako RAG. Instrukcja logowania i kontroli dostępu opisuje konfigurację Microsoft Entra oraz uprawnienia dokumentów. Zespół techniczny może wykorzystać demonstrację do pracy na przygotowanej próbce, zachować wyniki pytań i sprawdzić je na kontach o różnych uprawnieniach. Funkcje ochrony wymagają konfiguracji. Temat rozwija nagranie Microsoft Reactor o dostępie do danych w aplikacjach RAG.
Przykład opisany przez dostawcę: OpenAI opisuje u Morgan Stanley ocenę odpowiedzi przez ekspertów i rozwój zestawu pytań ewaluacyjnych. Warto wykorzystać samą praktykę: osoba znająca dane przygotowuje wzorzec, a kolejne wersje rozwiązania są sprawdzane na zapisanym zestawie pytań. Własne wyniki pozostają podstawą odbioru źródeł firmy.
4. Nakład pracy przy przygotowaniu i utrzymaniu danych
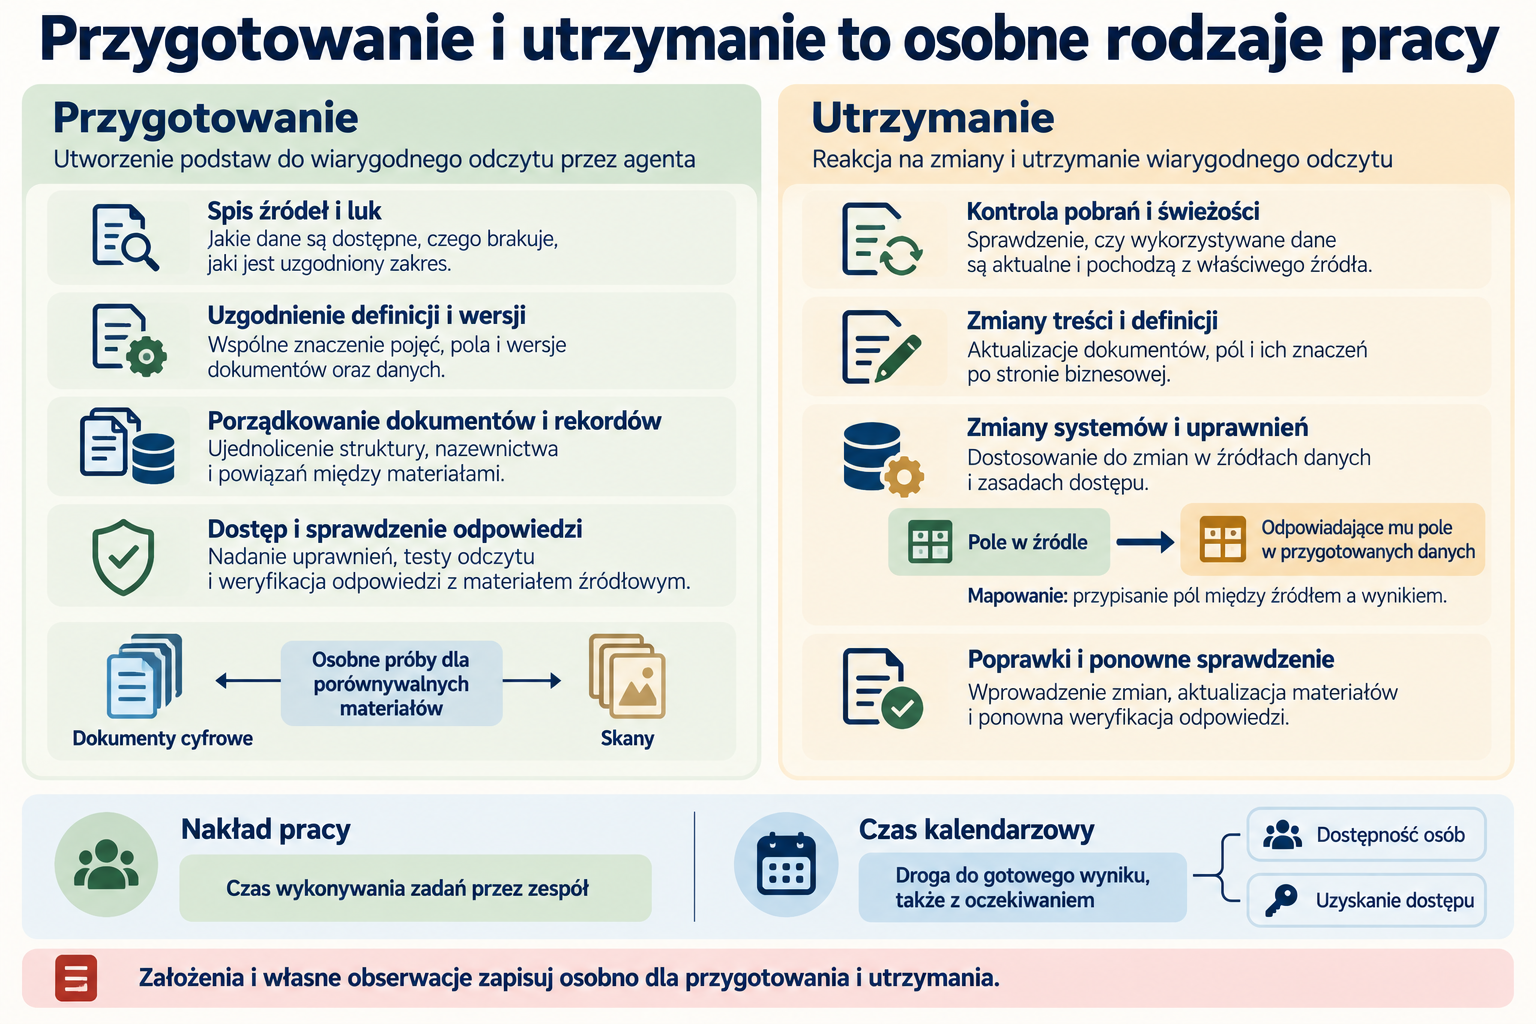
Nakład najlepiej oszacować na własnych źródłach. Liczba systemów daje zbyt mało informacji: jedna biblioteka może zawierać dobrze opisane dokumenty, a inna — skany, duplikaty i nierozstrzygnięte wersje. Osobno trzeba policzyć pracę przygotowawczą i późniejszą obsługę zmian.
4.1. Jednorazowe prace i udział zespołu
Koordynator zakłada arkusz nakładu powiązany z ID źródeł. Razem z wykonawcami dzieli materiały na klasy podobnej trudności: np. dokumenty cyfrowe i skany, źródła z gotowym odczytem i wymagające nowego połączenia, dane z uzgodnionymi oraz niejasnymi definicjami. Dla próbki z każdej klasy zapisuje liczbę jednostek, czas pracy według ról, poprawki i przyczyny oczekiwania. Ten pomiar służy oszacowaniu pozostałego zakresu; przegląd źródeł nadal obejmuje całą firmę.
| Zadanie | Skala i założenie do wpisania | Udział zespołu | Wynik pracy | Nakład do uzupełnienia |
|---|---|---|---|---|
| Spis źródeł | Obszary, znane źródła i nieustalone miejsca | Koordynator, pracownicy, administratorzy | Rejestr pokrycia i luk | Pozostała praca: (czas próby ÷ liczba źródeł w próbie) × liczba pozostałych porównywalnych źródeł. Do łącznego nakładu doliczyć czas wykonanej próby i wyjaśnień |
| Uzgodnienie znaczenia | Sporne pojęcia, wersje i wyjątki | Właściciele danych, analityk | Słownik i rozstrzygnięcia | Czas spotkań oraz pracy w źródłach |
| Porządkowanie dokumentów | Liczba i typ dokumentów, OCR, tabele, duplikaty | Opiekun treści, osoba techniczna | Sprawdzona reprezentacja z pochodzeniem | Pomiar dla klasy dokumentów i zaobserwowane poprawki |
| Przygotowanie rekordów | Zbiory, klucze, relacje, brakujące pola i historia | Administrator, inżynier danych, analityk | Powiązane i sprawdzone dane | Czas mapowań, uzupełnień oraz kontroli |
| Dostęp i aktualizacja | Konta, role, gotowość konektora i ograniczenia źródła | Administratorzy, właściciel danych | Odczyt zgodny z zakresem i dostępem | Praca konfiguracji; osobno czas oczekiwania na dostęp |
| Odbiór | Typy pytań, role i przypadki brzegowe | Właściciel, analityk lub tester | Wyniki sprawdzeń i zamknięte błędy | Przygotowanie wzorca, wykonanie, poprawki i ponowne sprawdzenie |
Szacunek składa się z prac wspólnych, pracy zależnej od skali źródeł oraz poprawek widocznych w próbce. Warto zapisać przedział i założenia, zamiast jednej liczby ukrywającej różnice między materiałami. Czas kalendarzowy ustalamy oddzielnie: zależy od dostępności właścicieli, uzyskania dostępu i kolejności zadań. Kilka godzin pracy rozłożonych między różne osoby może oznaczać znacznie dłuższe oczekiwanie na gotowy wynik.
Przykład: próba pokazuje, że cyfrowe umowy zachowują czytelne tabele, natomiast starsze skany wymagają ręcznego porównywania dat i kwot. Koordynator rozdziela te grupy w arkuszu i mierzy je osobno. Użycie jednej średniej dla całej biblioteki ukryłoby pracę nad skanami i liczbę potrzebnych poprawek.
4.2. Stała obsługa zmian i jakość danych
Po uruchomieniu dostępu arkusz nakładu powinien mieć drugą część: utrzymanie. Opiekunowie źródeł i integracji zapisują regularne czynności oraz pracę wywołaną zmianami. Częstość i czas biorą z obserwacji własnych danych, zgłoszeń i logów pobierania.
| Rodzaj pracy | Przykładowy zakres | Co mierzyć |
|---|---|---|
| Bieżąca kontrola | Poprawność pobrań, świeżość danych i obsługa zgłoszeń | Częstość kontroli, czas pracy oraz liczba i rodzaj usterek |
| Przegląd treści i definicji | Nieaktualne dokumenty, zmienione pojęcia, nieustaleni właściciele | Zakres przeglądu, czas uzgodnień i poprawek |
| Zmiana systemu lub źródła | Nowe pole, API, format, zbiór albo sposób dostępu | Czas dostosowania mapowania i ponownego odbioru |
| Zmiana uprawnień lub wycofanie danych | Nowa grupa odbiorców, odebranie dostępu, usunięcie źródła | Czas aktualizacji konfiguracji i sprawdzenia skutku w odpowiedzi |
Do planu kolejnego okresu trafia przewidywana liczba takich czynności i zmian, pomnożona przez zaobserwowany nakład dla danego typu. Nowy system lub duża przebudowa źródła wymaga osobnego oszacowania. Po pierwszym okresie obsługi koordynator porównuje plan z zapisem pracy i aktualizuje założenia.
Przykład opisany przez dostawcę: materiał o Fluxym i wsparciu Wesype opisuje udział administratora przy łączeniu SharePoint i Salesforce oraz pomocy pracownikom. To użyteczna wskazówka, by uwzględnić pracę ludzi przy źródłach i dostępie. Opis nie podaje pełnego bilansu godzin utrzymania danych całej firmy.
5. Odpowiedzialność i zasady utrzymywania danych
Przygotowany zbiór zaczyna się starzeć wraz z kolejnymi zmianami w firmie. Utrzymanie jego przydatności wymaga jasnych decyzji: kto rozstrzyga znaczenie informacji, kto poprawia źródło i kto potwierdza, że agent korzysta już z nowej wersji.
5.1. Właściciele źródeł i uzgadnianie definicji
Właściciel merytoryczny źródła powinien mieć prawo rozstrzygnięcia, która informacja obowiązuje i co oznaczają używane pojęcia. Administrator odpowiada za techniczny dostęp, ale nie powinien samodzielnie ustalać definicji „aktywnego klienta” albo zasad uznania dostawy za opóźnioną. Role i zastępstwa zapisujemy w karcie źródła.
| Rola | Odpowiedzialność dotycząca danych | Miejsce zapisu |
|---|---|---|
| Właściciel merytoryczny | Definicje, obowiązująca wersja i rozstrzyganie sprzeczności | Karta źródła, słownik, historia zatwierdzeń |
| Opiekun treści lub rekordów | Wykonanie poprawki, oznaczenie wersji i daty obowiązywania | System źródłowy |
| Administrator źródła | Konta, grupy, dostęp i zmiany schematu | Konfiguracja i rejestr zmian |
| Opiekun integracji | Pobranie zmian, odświeżenie indeksu, obsługa usunięć i awarii | Log synchronizacji i lista usterek |
| Osoba sprawdzająca | Porównanie odpowiedzi z materiałem referencyjnym | Rejestr pytań i wyników |
| Użytkownik odpowiedzi | Zgłoszenie braku lub błędu wraz z pytaniem i źródłem | Formularz zgłoszenia |
W mniejszej firmie jedna osoba może pełnić kilka ról. W zapisie nadal warto odróżniać rozstrzygnięcie, wykonanie poprawki i jej sprawdzenie. Nowa definicja powinna mieć autora, datę obowiązywania i wskazanie zbiorów, których dotyczy. Dzięki temu zmiana znaczenia pola nie zostaje zamknięta w rozmowie kilku osób.
Jeśli firma korzysta z katalogu danych, może utrwalać takie ustalenia jako kontrakty danych: uzgodniony opis schematu, znaczenia i oczekiwanej jakości. OpenMetadata dokumentuje kontrakty przypisane do zasobów. Właściciel i analityk zapisują w nich reguły, a osoba techniczna uruchamia dostępne sprawdzenia i zachowuje wyniki przy zasobie. Reguły wymagające osądu merytorycznego nadal sprawdza człowiek.
5.2. Zmiana w firmie jako powód aktualizacji danych
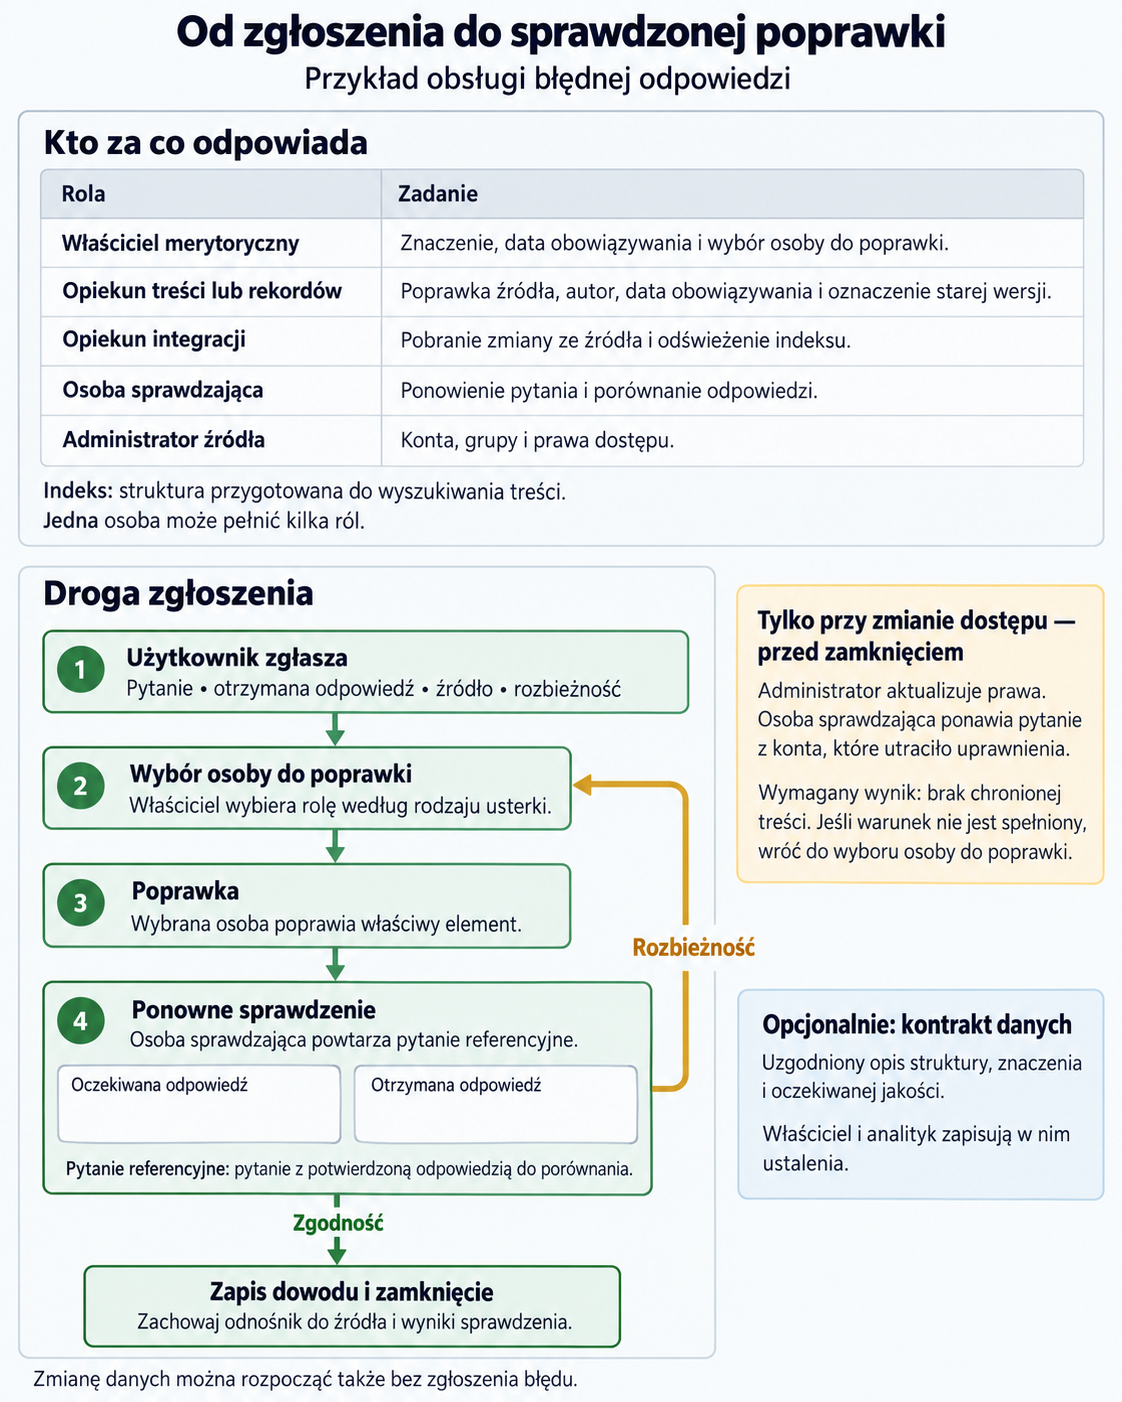
Zmianę warunków umowy, cennika lub definicji trzeba powiązać z aktualizacją właściwego źródła. Proponuję, aby zadanie dotyczące takiej zmiany zawierało również informację o skutku dla danych udostępnianych agentom. Opiekun źródła i integracji przechodzą wtedy tę samą ścieżkę:
- Zapisują zmianę w uzgodnionym źródle z autorem i datą obowiązywania.
- Oznaczają starą wersję jako historyczną lub wycofaną z bieżącego użycia.
- Sprawdzają pobranie nowej treści oraz aktualizację kopii lub indeksu.
- Powtarzają pytanie referencyjne i porównują odpowiedź z nowym stanem.
- W razie zmiany dostępu sprawdzają również wynik z konta, które utraciło uprawnienia.
- Zamykają zadanie z odnośnikiem do źródła i wyników sprawdzenia; rozbieżność wraca do odpowiedniej osoby.
Przykład: aneks klienta K-124 został podpisany, ale agent nadal podaje dawny termin płatności. Właściciel umów potwierdza, od kiedy aneks obowiązuje, a opiekun biblioteki uzupełnia właściwe oznaczenie. Opiekun integracji sprawdza, czy odczyt obejmuje aneks i czy stary fragment nie wraca jako aktualny. Uprawniony pracownik ponawia pytanie. W zgłoszeniu pozostają dokument, data i poprawna odpowiedź.
Zmiana treści, usunięcie dokumentu i odebranie dostępu mogą być obsługiwane przez różne mechanizmy. Dlatego w karcie źródła zapisujemy osobno sposób sprawdzenia każdego z tych zdarzeń. Sam komunikat o udanym odświeżeniu nie wystarcza do zamknięcia wszystkich trzech przypadków.
5.3. Nawyki pracy i zgłaszanie błędów danych
Zgodność danych z rzeczywistością zależy także od tego, gdzie pracownicy zapisują decyzje i jak zgłaszają pomyłki. W GitLab TeamOps wspólna wiedza opiera się na udokumentowanym źródle informacji. KCS, metoda pracy z wiedzą, opisuje spójną strukturę treści oraz rozróżnia samodzielną poprawę i oznaczenie błędu do naprawy. Te praktyki można przełożyć na reguły dotyczące firmowych źródeł.
- Decyzja zmieniająca informację trafia do uzgodnionego źródła. W rozmowie lub wiadomości zostaje link do tego zapisu.
- Nowy dokument korzysta ze wspólnego szablonu z właścicielem, datą obowiązywania i statusem wersji. Autor uzupełnia te pola przed udostępnieniem.
- Pracownik mający prawo poprawy zmienia źródło i opisuje zmianę. Osoba bez takiego prawa zgłasza błąd przez formularz powiązany z kartą źródła.
- Zgłoszenie odpowiedzi agenta zawiera pytanie, otrzymaną odpowiedź, wskazane źródło i opis rozbieżności. Użytkownik nie musi rozpoznawać przyczyny technicznej.
- Właściciel wskazuje osobę naprawiającą, a zamknięcie zgłoszenia wymaga wyniku ponownego pytania. Poprawka pozostaje w źródle, aby mogły z niej korzystać kolejne osoby i odczyty.
Celem jest stałe wykrywanie i skracanie czasu trwania rozbieżności. Gdy pracownik widzi, że zgłoszenie doprowadziło do poprawy źródła i odpowiedzi, ma powód korzystać z tej samej drogi następnym razem. Rejestr usterek pozwala też wskazać źródła, którym potrzebny jest szerszy przegląd.
6. Lista kontrolna gotowości danych dla agentów
Do odbioru przygotowanych danych zaprosiłbym właścicieli źródeł, administratorów i osoby sprawdzające odpowiedzi. Każdy punkt poniżej powinien prowadzić do istniejącego zapisu lub wyniku sprawdzenia.
- Rejestr obejmuje wszystkie obszary firmy i sześć grup źródeł ze wstępu; zaznaczono też brak danej grupy, nieznany zakres i źródła jeszcze niedostępne.
- Każde udostępniane źródło ma właściciela, pochodzenie, zakres, definicje i wskazaną wersję obowiązującą.
- Dokumenty oraz rekordy zachowują identyfikatory, a historia jest dostępna tam, gdzie wymaga jej pytanie.
- Interpretacje diagramów i uzupełnienia wykonane przez agentów zostały sprawdzone przez ludzi znających źródła.
- Istnieją zgodne wyniki pytania o szczegół oraz analizy zbioru, z odnośnikami do materiału referencyjnego.
- Sprawdzono zmianę treści, wycofanie danych i odebranie dostępu na całej drodze do odpowiedzi.
- Zmierzono czas odpowiedzi dla opisanych warunków oraz ustalono wymaganą świeżość poszczególnych źródeł.
- Arkusz nakładu oddziela przygotowanie od utrzymania i zachowuje założenia oraz własne pomiary.
- Ustalono odpowiedzialność za zmiany i błędy, a pozostałe braki mają adresata oraz następne zadanie.
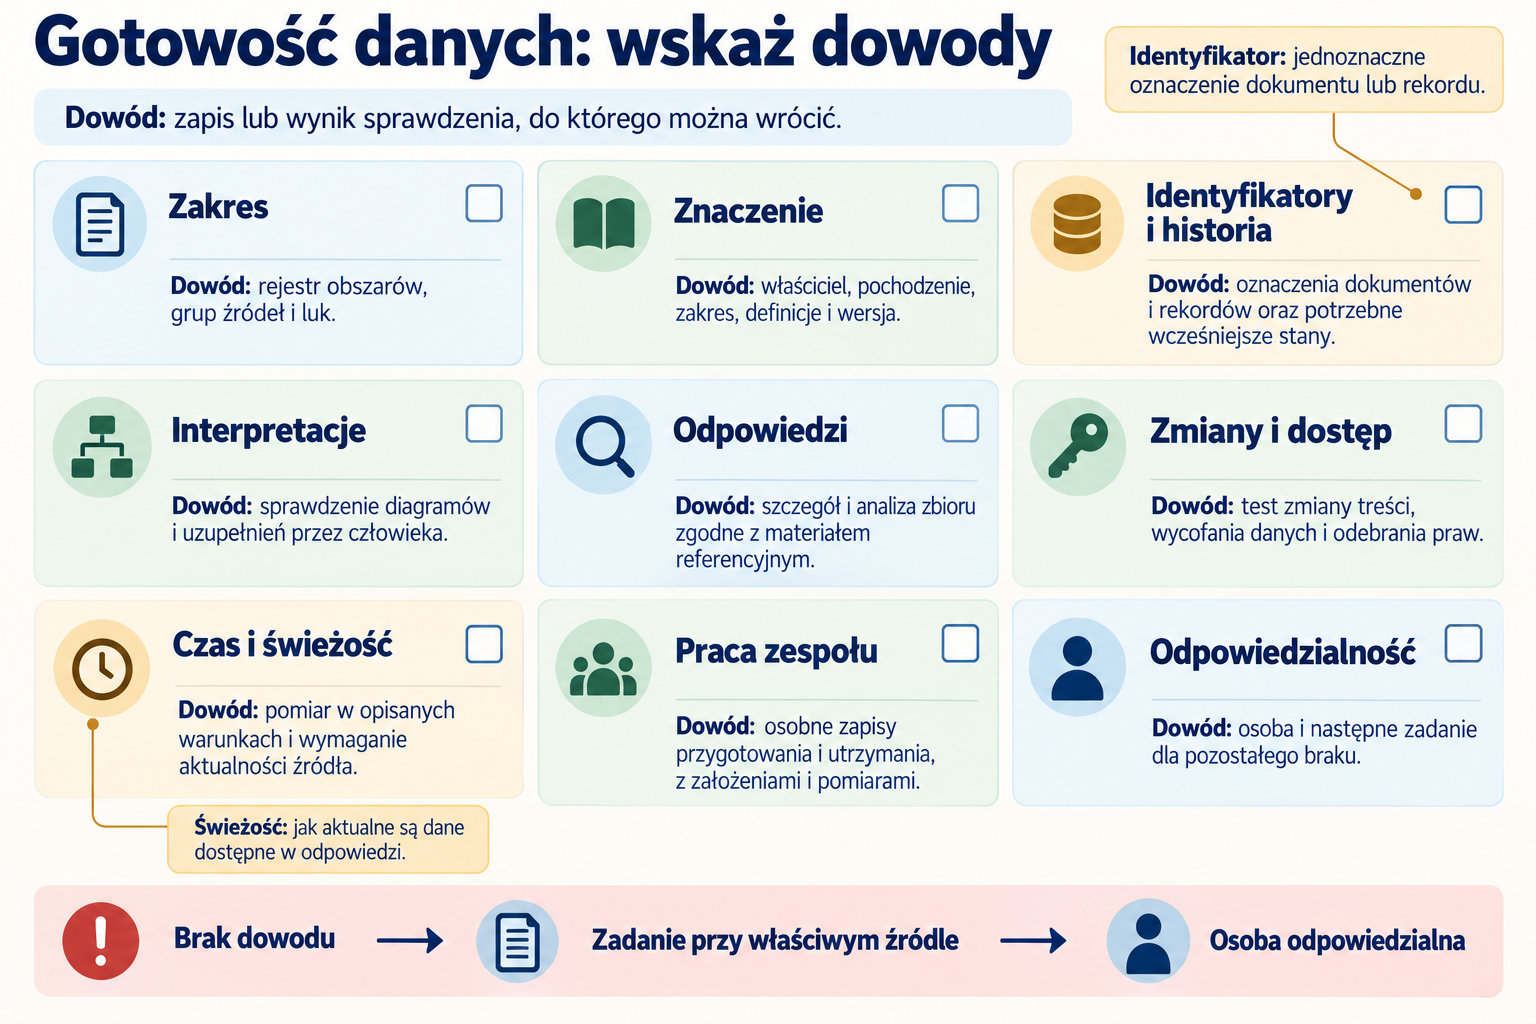
Brak dowodu wraca na listę prac przy właściwym źródle. Tak przygotowana firma wie, na jakich danych agent może polegać, czego jeszcze nie ma i kto odpowiada za poprawę. Jej wiedza staje się zasobem, który można odnaleźć, sprawdzić i utrzymywać wraz ze zmianami w firmie.